빅데이터 분산 시스템을 구현하면서, 자연스럽게 이런 의문이 들게 되었다.
지금 빅데이터 분산 서버가 제대로 동작하고 있는 게 맞나?
"
빅데이터 분산 서비스에서는, 뉴스가 처음 수집되는 collector부터 마지막 DBWriter까지, 여러 단계를 거쳐서 가공되어 전달된다.
이 과정에서 중간에 병목현상이 없는지, 오류가 나서 유실되고 있는 정보는 없는지, CPU 과부하가 발생하고 있지는 않은지 등을 파악할 수 있는 시스템이 필요했다.
그래서 우리 서비스에, 프로메테우스, 로키, 그라파나를 두어서 모니터링을 할 수 있도록 해보고자 한다.
그전에 이것들이 어떤 역할을 해서 우리 서비스를 모니터링할 수 있는지 배워보자.
모니터링을 하기 위해서 우리는 다시 3가지 고민을 해보아야 한다.
1. 모니터링 지표를 어떻게 만들어낼까?
2. 만들어낸 모니터링 지표들을 누가 저장할까?
3. 이렇게 저장된 데이터들을 어떻게 보여줄까?
이 세가지의 고민들에 대해서 하나씩 살펴보자.
1. 모니터링 지표를 만드는 과정
Exporter
모니터링을 하기 위해서는, 우리 서비스의 각 애플리케이션 (ec2, 카프카, hdfs, spark)을 읽어서 보고하는 Exporter가 필요하다.
이 Exporter들은 "/metrics"라는 엔드포인드로 정보를 넘겨준다.
이 "/metrics" 엔드포인트를 어떻게 설정하는 것인지는 뒤에 다시 언급하겠다.
실제 군대를 예로 들어보자.
지휘통제실이 있으면, 각 초소의 경계병들이, 초소의 현황을 실시간으로 보고한다. 이 초소의 경계병들이 Exporter가 되는 것이다.
각 애플리케이션의 Exporter가 "/metrics"라는 곳으로 정보를 넘겨준다.
예를 들면, 다음과 같이 "/metrics" 엔드포인트에 정보를 전달한다.
kafka:7071/metrics
hdfs-exporter:9120/metrics
spark-stream:9102/metrics
이렇게 "/metrics" 엔드포인트로 정보를 모으는 역할을 하는 경비병이 Exporter이다.
Loki
단순히 수치만으로는 이해되지 않는 상황도 있을 것이다.
군대를 예시로 들어보자.
"000초소에 문제가 생겼습니다!"
문제가 생겼다는 건 확실히 알 수 있다. 평소와는 다른 무슨 일이 생긴 것이다.
근데 그 무슨 일이 정확히 뭔지까지는 알 수가 없다.
우리는 그래서 중요한 로직에는 Log를 찍도록 설정해놓고, 문제가 발생했을 때 대응을 할 수 있도록 한다.
Loki는 이렇게 심어놓은 Log들을 집계할 수 있는 시스템이다.
간단히 표현하면 다음과 같다.
여러 서버와 Container에서 발생하는 Log를 한곳에 모아 저장하고 검색할 수 있게 해주는 시스템
지금 우리 서비에는 여러 개의 컨테이너들이 동작하고 있다.
Kafka
Spark Master
Spark Worker
Spark Driver
HDFS NameNode
HDFS DataNode
Collector
Backend
이렇게 많은 컨테이너들에서 발생하는 로그들을 일일히 우리가 찾아가서 로그를 확인한다면 얼마나 불편하겠는가
그런 불편함을 Loki를 이용해서 해결한다.
예를 들어 다음과 같은 명령으로, Loki에게 물어볼 수 있다.
최근 30분간 Kafka ERROR 로그 보여줘.
로그 수집기
Loki가 직접 우리 서비스의 로그들을 수집하는 구조는 아니다.
Grafana의 Alloy를 통해 로그들을 수집하여 Loki에 전달한다.
2. 만들어낸 모니터링 지표들을 저장하는 과정
앞서, "/metrics" 엔드포인트에 데이터를 전달하는 Exporter를 알아보았다.
이제 "/metrcis"에 전달된 데이터들을 어떻게 저장을 하는지 살펴보자.
Prometheus
데이터를 수집하여 저장한다.
Prometheus의 역할은, "metrics"에 쌓인 데이터들을 가져와서 시계열 데이터로 저장하는 것이다.
우리는 단순히 서비스의 현황을 아는 것 뿐만 아니라, 특정 시점에 우리 서비스의 내부 상황이 어땠는지 알아야할 필요성이 있다.
특정 시간에 특이사항이 발생했다는 것을 알기 위해서는, Exporter가 던져준 정보들을 시간 정보와 함께 저장을 해놓아야하고, 이 역할을 Prometheus가 담당한다.
또 군대로 예를 들어보자.
아까 Exporter가 경계병이라면, Prometheus는 지휘통제실에서 일하는 행정병이다.
몇시 몇분 몇초에 초소 상황이 어땠는지를 정리하는 역할을 하는 것이다.
Prometheus의 역할은 단순히 저장일까?
그렇지 않다.
Prometheus의 강력한 기능 중 하나인 PromQL이 있다.
이름만 들어보면 SQL과 비슷한 느낌인가? 생각할 수 있는데, 정확하다.
MySQL에서도 데이터를 저장을 하면, 그걸 우리가 원하는 입맛에 맞게 조회 쿼리를 쏴서 정보를 확인할 수도 있듯이, Prometheus에서도, 데이터를 단순 저장하는 것뿐만 아니라, 우리가 필요한 모니터링 정보로 가공할 수 있는 기능을 가지고 있다.
예를 들어, 일장 시간 동안 카프카의 특정 토픽에 저장되는 메세지의 속도를 관측한다거나, 카프카의 모든 토픽에 발생하는 메세지의 총량 계산등을 할 수 있는 것이다.
바로 위에서 말했듯이, 프로메테우스에서는, "/metrics" 엔드포인트에 쌓인 정보들을 스크랩하여 시계열 데이터로 저장하는 역할을 수행한다.
3. 저장된 데이터를 보여주는 방법
위에서, 모니터링 데이터를 저장하고 가공하는 단계까지 간단하게 알아보았다.
그렇다면, 이렇게 저장된 데이터를 어떻게 보여줄지 고민을 하게 된다.
그 고민을 Grafana가 해결해준다.
Grafana
여러 Data Source에 있는 데이터를 조회해서, 사람이 보기 편하게 시각화하는 것
또 군대로 예를 들어보자.
아까 지휘통제실의 관측병이 각 초소의 상황을 시계열 데이터로 정리했다면, 이렇게 정리된 데이터들을 가지고 각 초소의 현황을 당직사관님께 보고드리는 사람도 있을 것이다. 당직사관님이, 관측병이 작성한 자료들을 직접 보는 것도 물론 가능하겠지만, 그것보다는 보고자가 그 자료들을 보고서 형태로 예쁘게 정리해서 브리핑하는 것이, 각 초소의 상황을 이해하는데에 더 도움이 될 것이다.
그래서 이 보고자가 바로 Grafana의 역할과 똑같다.
Grafana를 사용하면, 아래와 같은 예쁜 그래프를 쉽게 만들어낼 수 있다.
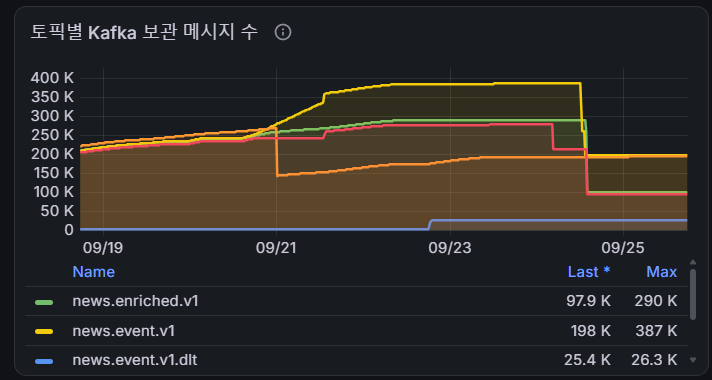
아까 Grafana의 정의를 설명할 때, DataSource라는 말을 사용했다.
쉽게 말해서 DataSource는, "Grafana가 예쁘게 보고서 형태로 만들어 낼 자료들이 모여있는 곳"이다.
우리 서비스 기준으로 DataSource는 Prometheus와 Loki가 될 것이다.
우리 서비스의 모니터링 flow
앞서 이론적인 내용은 대충 설명을 했으니, 우리 서비스의 모니터링 flow에 대해서 말하고자 한다.
Exporter
우리 서비스에 어떤 초병들이 있는지 소개해보겠다.
Kafka
Kafka에는 2개의 Exporter가 있다.
- Broker의 내부 상태를 감시하는 JMX Exporter
- Topic과 Consumer의 상태를 감시하는 Kafka Exporter
JMX Exporter
Kafka 자체는, JVM 기반 애플리케이션이기 때문에, 내부 상태를 JMX라는 방식으로 제공한다.
초당 들어온 메시지 수
초당 들어온 Byte
초당 나간 Byte
Partition 개수
Offline Partition
요청 처리 시간
JVM Heap 사용량
GC 발생 시간
JMX 방식으로 제공된 값은, prometheus가 이해하지 못한다.
그렇기 때문에 JMX Exporter를 이용해서, JMX 방식으로 제공된 값들을 Prometheus가 이해할 수 있도록 변환한다.
kafka_server_brokertopicmetrics_messagesin_total 120392

kafka_server_brokertopicmetrics_bytesin_total 92481203

kafka_log_size_bytes{
    topic="news.raw.v1",
    partition="0"
} 58293012
Kafka Exporter
서비스적으로 진짜 중요한 정보가 하나 더 있다.
바로 "지금 미처리된 메세지의 수", 즉, Consumer Lag이다.
Kafka Exporter르 이용해서, 특정 Topic의 최신 offset과, 현재 Consumer가 처리한 Offset을 비교해서, 미처리 메세지 수를 계산할 수 있다.
JMX Exporter와 Kafka Exporter를 간단히 설명하면 다음과 같다.
JMX Exporter
→ Kafka 자체가 건강한가?

Kafka Exporter
→ Kafka 안의 데이터가 잘 소비되고 있는가?
EC2
앞서 설명한 Kafka에는 공식 Exporter가 있었기 때문에, "/metrics" 경로가 공식적으로 존재했다.
즉, 특정 값을 직접 가공하지 않아도 prometheus가 이해할 수 있는 형태로 알아서 가공을 해주었다.
하지만 EC2에는 "metrics"로 변환해주는 api가 없기 때문에 Node Exporter를 이용한다.
Node Exporter
Node Exporter는 Linux의 "proc", "/sys", "filesystem"등을 읽고, 이걸 Prometheus가 이해할 수 있는 형태로 변환한다.
이 Node Exporter를 이용해서 다음과 같은 정보를 프로메테우스가 가져갈 수 있다.
CPU 사용률
Memory 사용량
Disk 사용량
Disk Read / Write
HDFS
HDFS에서 우리가 얻고 싶은 정보는 다음과 같다.
전체 저장 용량
사용 중인 용량
남은 용량

Live DataNode 수
Dead DataNode 수

Block 수
Missing Block
Under Replicated Block

특정 HDFS 경로가 차지하는 용량
HDFS에도, 공식적인 Exporter인 HDFS Exporter가 있기 때문에, 이 Exporter가 Prometheus 형식으로 바꿔준다.
Spark
Spark에서는 조금 다른 구조를 가지고 있다.
Spark의 자체 Exporter가 있긴 하지만, 우리가 알고 싶은 것은 다음과 같다.
지금 Query가 실행 중인가?

이번 Batch에 몇 개가 들어왔는가?

초당 몇 건이 들어오는가?

초당 몇 건을 처리하고 있는가?

한 Batch를 처리하는 데 몇 초 걸렸는가?

Kafka Offset을 어디까지 처리했는가?
그래서, 우리 프로젝트에서는 Spark 내부의 StreamingQueryListener를 이용해서, Prometheus 형식으로 직접 변환하는 Exporter를 구현했다.
Spark가 배치 하나를 처리할 때마다, StreamingQueryListener가 이벤트를 받고, 그 시점의 입력량, 처리속도, 배치 시간, Kafka Offset를 Prometheus용 Metric에 기록한다.
Prometheus의 턴
이렇게 여러 Exporter들이 "/metrics"에 정보를 전달하고 나면, Prometheus는 이 정보들을 읽는다.
다음과 같이, 어디에 가면 metric을 얻을 수 있는지 prometheus 설정 파일을 따로 구현해주어야 한다.
scrape_configs:

  - job_name: kafka-broker
    static_configs:
      - targets:
          - kafka:7071

  - job_name: kafka-offsets
    static_configs:
      - targets:
          - kafka-exporter:9308

  - job_name: node
    static_configs:
      - targets:
          - node-exporter:9100

  - job_name: hdfs
    static_configs:
      - targets:
          - hdfs-exporter:9120

  - job_name: spark-streaming
    static_configs:
      - targets:
          - spark-enriched-stream:9102
그리고 위의 metrics 경로를 통해 가져온 값들에 timestamp를 붙여서 저장한다.
12:00:00 kafka_consumergroup_lag = 100
12:00:15 kafka_consumergroup_lag = 120
12:00:30 kafka_consumergroup_lag = 170
12:00:45 kafka_consumergroup_lag = 250
그리고 prometheus의 핵심 기능인 promQL을 통해, 집계 연산한 결과도 metrics에 저장한다.
groups:
  - name: pipeline-recording
    interval: 15s
    rules:
      - record: witw:kafka_retained_records
        expr: sum by (topic) (kafka_topic_partition_current_offset - kafka_topic_partition_oldest_offset)

      - record: witw:kafka_nlp_input_records_per_second
        expr: clamp_min(sum(deriv(kafka_topic_partition_current_offset{topic="news.raw.v1"}[5m])), 0)

      - record: witw:kafka_nlp_committed_records_per_second
        expr: clamp_min(sum(deriv(kafka_consumergroup_current_offset{consumergroup="nlp-worker-v1",topic="news.raw.v1"}[5m])), 0)

      - record: witw:kafka_nlp_output_records_per_second
        expr: clamp_min(sum(deriv(kafka_topic_partition_current_offset{topic="news.enriched.v1"}[5m])), 0)

      - record: witw:kafka_nlp_consumer_lag
        expr: sum(kafka_consumergroup_lag{consumergroup="nlp-worker-v1",topic="news.raw.v1"}) or vector(0)

      - record: witw:kafka_nlp_consumer_members
        expr: sum(kafka_consumergroup_members{consumergroup="nlp-worker-v1"}) or vector(0)

      - record: witw:spark_source_lag
        expr: clamp_min(max by (topic, partition) (kafka_topic_partition_current_offset) - on (topic, partition) group_right witw_spark_streaming_source_offset, 0)
우리 서비스에서는, 도커 volume에다가 이 정보들을 영구 저장한다.
Grafana
Grafana에서는, 다음처럼, 프론트 화면을 구성하는 코드를 작성한다.
{
  "uid": "witw-backend-db",
  "title": "WITW · Spring & PostgreSQL",
  "schemaVersion": 39,
  "version": 3,
  "refresh": "15s",
  "time": {
    "from": "now-30m",
    "to": "now"
  },
  "tags": [
    "backend",
    "prod"
  ],
  "panels": [
    {
      "id": 1,
      "title": "API 요청 수",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "reqps",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "sum(rate(http_server_requests_seconds_count{env=\"prod\",job=\"backend\",uri=~\"/api/.*\"}[$__rate_interval]))",
          "legendFormat": "요청/초"
        }
      ]
    },
    {
      "id": 2,
      "title": "API 응답시간",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "s",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "sum(rate(http_server_requests_seconds_sum{env=\"prod\",job=\"backend\",uri=~\"/api/.*\"}[$__rate_interval])) / sum(rate(http_server_requests_seconds_count{env=\"prod\",job=\"backend\",uri=~\"/api/.*\"}[$__rate_interval]))",
          "legendFormat": "평균"
        },
        {
          "refId": "B",
          "expr": "histogram_quantile(0.95, sum by (le) (rate(http_server_requests_seconds_bucket{env=\"prod\",job=\"backend\",uri=~\"/api/.*\"}[$__rate_interval])))",
          "legendFormat": "p95"
        }
      ]
    },
    {
      "id": 3,
      "title": "API 5xx 비율",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percentunit",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "(sum(rate(http_server_requests_seconds_count{env=\"prod\",job=\"backend\",uri=~\"/api/.*\",status=~\"5..\"}[$__rate_interval])) or (0 * sum(rate(http_server_requests_seconds_count{env=\"prod\",job=\"backend\",uri=~\"/api/.*\"}[$__rate_interval])))) / sum(rate(http_server_requests_seconds_count{env=\"prod\",job=\"backend\",uri=~\"/api/.*\"}[$__rate_interval]))",
          "legendFormat": "5xx"
        }
      ]
    },
    {
      "id": 4,
      "title": "JVM Heap",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "bytes",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "sum(jvm_memory_used_bytes{env=\"prod\",job=\"backend\",area=\"heap\"})",
          "legendFormat": "사용"
        },
        {
          "refId": "B",
          "expr": "sum(jvm_memory_max_bytes{env=\"prod\",job=\"backend\",area=\"heap\"})",
          "legendFormat": "최대"
        }
      ]
    },
    {
      "id": 5,
      "title": "DB 커넥션 풀",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 16,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "short",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "hikaricp_connections_active{env=\"prod\",job=\"backend\"}",
          "legendFormat": "사용 중"
        },
        {
          "refId": "B",
          "expr": "hikaricp_connections_pending{env=\"prod\",job=\"backend\"}",
          "legendFormat": "대기"
        },
        {
          "refId": "C",
          "expr": "hikaricp_connections_max{env=\"prod\",job=\"backend\"}",
          "legendFormat": "최대"
        }
      ]
    },
    {
      "id": 6,
      "title": "PostgreSQL 연결 수",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 16,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "short",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "pg_stat_database_numbackends{env=\"prod\",job=\"postgres\",datname=\"witw\"}",
          "legendFormat": "전체 연결 (idle 포함)"
        }
      ]
    },
    {
      "id": 7,
      "title": "PostgreSQL 트랜잭션",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 24,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "ops",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "rate(pg_stat_database_xact_commit{env=\"prod\",job=\"postgres\",datname=\"witw\"}[$__rate_interval])",
          "legendFormat": "커밋/초"
        },
        {
          "refId": "B",
          "expr": "rate(pg_stat_database_xact_rollback{env=\"prod\",job=\"postgres\",datname=\"witw\"}[$__rate_interval])",
          "legendFormat": "롤백/초"
        }
      ]
    },
    {
      "id": 8,
      "title": "PostgreSQL 데드락 (최근 5분)",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 24,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "short",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "increase(pg_stat_database_deadlocks{env=\"prod\",job=\"postgres\",datname=\"witw\"}[5m])",
          "legendFormat": "데드락"
        }
      ]
    },
    {
      "id": 9,
      "title": "EC2 CPU 사용률",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 32,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percent",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{env=\"prod\",job=\"node\",mode=\"idle\"}[5m])))",
          "legendFormat": "CPU"
        }
      ]
    },
    {
      "id": 10,
      "title": "EC2 메모리 사용률",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 32,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percent",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "100 * (1 - node_memory_MemAvailable_bytes{env=\"prod\",job=\"node\"} / node_memory_MemTotal_bytes{env=\"prod\",job=\"node\"})",
          "legendFormat": "메모리"
        }
      ]
    },
    {
      "id": 11,
      "title": "EC2 디스크 사용률",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 40,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percent",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "100 * (1 - node_filesystem_avail_bytes{env=\"prod\",job=\"node\",fstype!~\"tmpfs|overlay|squashfs\",device!~\"rootfs\",mountpoint!~\"/run.*|/var/lib/docker/.+\"} / node_filesystem_size_bytes{env=\"prod\",job=\"node\",fstype!~\"tmpfs|overlay|squashfs\",device!~\"rootfs\",mountpoint!~\"/run.*|/var/lib/docker/.+\"})",
          "legendFormat": "{{mountpoint}}"
        }
      ]
    },
    {
      "id": 12,
      "title": "EC2 디스크 읽기·쓰기",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 40,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "Bps",
          "min": 0
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "expr": "rate(node_disk_read_bytes_total{env=\"prod\",job=\"node\",device!~\"loop.*|ram.*\"}[5m])",
          "legendFormat": "{{device}} 읽기"
        },
        {
          "refId": "B",
          "expr": "rate(node_disk_written_bytes_total{env=\"prod\",job=\"node\",device!~\"loop.*|ram.*\"}[5m])",
          "legendFormat": "{{device}} 쓰기"
        }
      ]
    }
  ]
}
배운점
이번 서비스를 개발하면서, 프로메테우스, 그라파나, 로키를 처음 알았다.
이전까지는, 개발을 진행하면서 발생하는 버그를 파악할 때 docker 명령어로 로그를 뜯어보거나, 아니면 개발자모드를 켜서 네트워크 로그를 보는 방식으로 디버깅을 했었는데, 이 삼대장을 이용해서 모니터링 시스템을 구축해둔다면, 그라파나 웹페이지 하나만으로 서비스의 상태를 파악할 수 있어서 엄청난 장점이 있다고 생각한다.
모니터링 시스템은, 어떤 서비스에든 구축할 수 있는 시스템이고, 이제는 이 모니터링 시스템을 맛봤기 때문에, 앞으로 서비스를 개발할 때 이 모니터링 시스템은 무조건 구축을 할 것 같다.
그러니까 앞으로 모니터링 시스템을 더 깊게 파면서, 나와 같이 개발하는 팀원들이, 우리 서비스의 디버깅 및 상태 현황 파악을 용이하게 할 수 있도록 구현해보겠다.
'개인 프로젝트' 카테고리의 다른 글
| 05. 다중 채팅방 구조로의 확장 + 채팅 시스템 구축 (0) | 2025.07.18 |
|---|---|
| 04. 질문 기능 관련 구현 (1) | 2025.07.14 |
| 03. 이메일 인증 구현 (1) | 2025.07.10 |
| 02. 인증 시스템 구축 (1) | 2025.07.09 |
| 01. Entity 설계 (3) | 2025.07.08 |