이번 포스팅에서는, 지난 2주일간 설계한 파이프라인대로, 우리 서비스의 주재료가 되는 뉴스가, 실제로 어떻게 저장이 되어서 가공 처리가 되어 사용자의 눈에 보이게 되는지 구현해나간 과정을 담겠다.
우리 서비스에서는 카프카를 적극적으로 도입하여 파이프라인을 설계했기 때문에, 이번 포스팅에서는 카프카를 위주로 설명을 할 예정이다.
전체적인 파이프라인
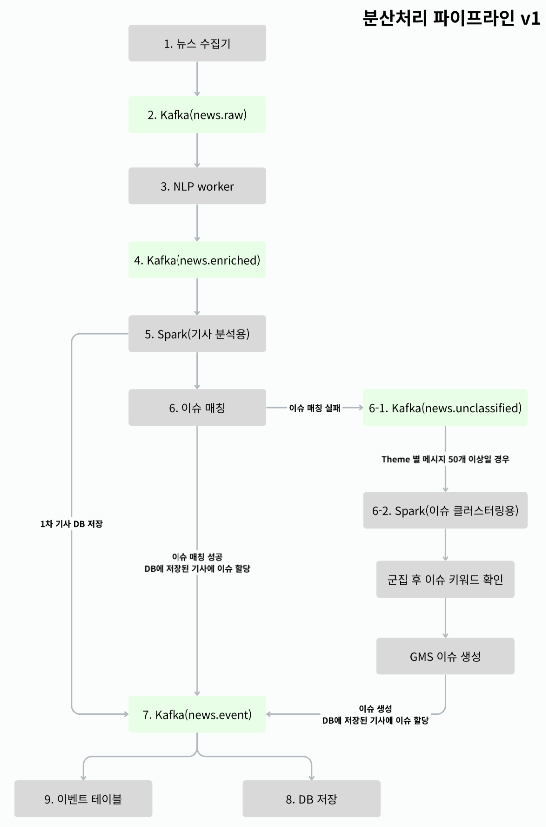
도커 환경에서의 카프카
우리 서비스는 도커 환경에서 돌아간다.
FROM apache/kafka:4.3.1그렇기 때문에, 아파치에서 제공하는 공식 카프카 이미지를 이용해 컨테이너를 만들었다.
외부 포트 연결
우리 서비스는 단순히 뉴스를 그대로 받아서 보여주는 게 아니라, 가공처리를 하여 유의미한 데이터를 뽑아내어 사용자에게 보여주는 데에 의의를 둔다.
그렇기 때문에 GPU 서버를 이용해서 뉴스를 가공한다.
하지만 GPU 서버는 빅데이터 분산용 ec2와 분리된 서버이기 때문에, 이 GPU 서버에서 빅데이터 분산용 ec2 서버 내의 카프카 컨테이너에 접근할 수 있는 포트를 열여주어야 한다.
이렇게 하면 빅데이터 분산용 ec2의 19092 포트로 들어오면, 카프카 컨테이너의 9092 포트로 연결된다.
ports:
  - "${KAFKA_BIND_HOST:?KAFKA_BIND_HOST must be set}:19092:9092"
ufw로 외부 접근 허용
위의 port 설정만 해준다고 끝이 아니다.
실제로, 외부 서버에서 19092 포트로 접근을 허용흘 해주어야 한다.
우리 서비스에서는 보안상, gpu 서버의 ip가 19092로 접근하는 것만 허용해주었다.
ufw란?
리눅스에서 복잡한 방화벽 설정을 아주 간단하게 관리할 수 있도록 도와주는 방화벽 관리 프로그램
sudo ufw allow from <GPU서버_IP> to any port 19092 proto tcp이렇게 함으로써, gpu 서버에서 우리 서버의 19092 포트로 접근이 가능해지고, 19092 포트로 접근을 하면 바로 빅데이터분산 ec2의 9092 포트로 연결되어, 우리 서비스의 카프카와 통신이 가능해진다.
KRaft 설정
KRaft는 카프카가 메타데이터(브로커 생사 여부, 토픽 및 파티션 구성 등)를 관리할 수 있게 만든 방식이다.
현재 우리 서비스는 빅데이터 분산용 ec2가 한 대이기 때문에, 단일 노드 기반이고, 이 노드가 브로커 역할도하고 controller 역할도 하고 있다.
- 브로커 : 메세지 저장과 Producer·Consumer 요청 처리를 담당하는 역할
- 컨트롤러: 클러스터(뉴스 카프카 서비스) 메타데이터 관리
ec2를 여러대 제공을 받으면 여러 노드를 두어 브로커를 여러 개 두는 방식을 고려할 수 있지만 지금은 그것까진 고려하지 않는다.
리스너 설정
우리 서비스에서 카프카가 통신하는 경로는 크게 3가지 이다.
| 29092 | Docker 내부 컨테이너 통신 | 빅데이터 분산 ec2 내에서 다른 프로젝트(뉴스 수집기, spark)와 통신 |
|---|---|---|
| 9092 | Docker 외부 서버 통신 | GPU 서버, 백엔드 서버와 통신 |
| 9093 | KRaft 컨트롤러 통신 | 뉴스 카프카의 메타데이터 관리 |
토픽 및 파티션 설정
create_topic "news.raw.v1" 6
create_topic "news.enriched.v1" 6
create_topic "news.unclassified.v1" 6
create_topic "news.event.v1" 3
각 토픽별로 파티션을 여러개 두었지만, 우리 서비스에서는 사실상 각 토픽들을 소비하는 주체가 각각 하나씩 있기 때문에 지금은 의미가 있진 않지만, 확장성을 고려하여 여러개의 파티션을 두었다.
뉴스 수집기에서 뉴스 원문 발행
우리 서비스의 가장 첫단추인 뉴스 수집기 코드를 살펴보자.
뉴스 메세지의 형태
{
  "article_id": "URL의 SHA-256 해시",
  "source_id": "example-source",
  "source_name": "example.com",
  "country": "South Korea",
  "article_url": "https://example.com/news/123",
  "published_at": "2026-09-13T00:00:00+00:00",
  "discovered_at": "2026-09-13T00:05:00+00:00",
  "title": "예시 기사 제목",
  "body": "수집한 기사 본문",
  "success": true,
  "http_status": 200
}
Producer 설정
from confluent_kafka import Producer

self.producer = Producer({
    # 우리 ec2에서 internal 주소
    "bootstrap.servers": bootstrap_servers,
    # Producer 이름
    "client.id": "news-collector",
    # 메시지를 성공으로 판단하기 전에 몇 개의 kafka 복제본으로부터 확인 받을지 결정
    # 어차피 지금은 복제본이 하나밖에 없어서, 여기에 저장이 잘되면 완료처리됨
    "acks": "all",
    # 네트워크 문제로 Producer가 같은 메세지를 내부적으로 재전송했을 때, kafka에 중복 저장을 막음
    "enable.idempotence": True,
    # 메세지를 kaffka로 전송하기 전에 메세지 배치 단위로 snappy로 압축
    "compression.type": "snappy",
    # 메세지를 30초안에 전송하지 못하면 실패처리
    "delivery.timeout.ms": 30000,
})
produce 코드
self.producer.produce(
    self.topic,
    key=article_id,
    value=payload,
    callback=self._delivery_callback,
)
적재된 뉴스 원문 이벤트 소비
위에서 news-collector에 의해, news.raw에 적재된 이벤트는 두가지 경로에 의해 소비가 된다.
- nlpworker
- hdfs
nlpworker
원문을 받아서 뉴스를 가공하기 위해, news.raw에 적재된 원문을 consume하여 가공한다.
성공적으로
from confluent_kafka import Consumer, KafkaError

from config import (
    KAFKA_BOOTSTRAP_SERVERS, KAFKA_RAW_TOPIC,
    KAFKA_CONSUMER_GROUP, NLP_BATCH_SIZE,
)

def create_consumer():
    if NLP_BATCH_SIZE <= 0:
        raise ValueError("NLP_BATCH_SIZE must be positive")
    consumer = Consumer({
        "bootstrap.servers": KAFKA_BOOTSTRAP_SERVERS,
        "group.id": KAFKA_CONSUMER_GROUP,
        "auto.offset.reset": "earliest",
        "enable.auto.commit": False,
    })
    try:
        consumer.subscribe([KAFKA_RAW_TOPIC])
    except BaseException:
        consumer.close()
        raise
    return consumer

def consume_batch(consumer):
    batch = []
    while len(batch) < NLP_BATCH_SIZE:
        message = consumer.poll(timeout=1.0)
        if message is None:
            break
        if message.error():
            if message.error().code() == KafkaError._PARTITION_EOF:
                continue
            raise RuntimeError(f"Kafka consumer error: {message.error()}")

        item = {"message": message, "article": None}
        try:
            value = message.value()
            if value is None:
                raise ValueError("null Kafka payload")
            item["article"] = json.loads(
                value.decode("utf-8"), parse_constant=_reject_constant,
            )
            # Reject overflowed numbers and lone surrogates before archiving.
            json.dumps(item["article"], allow_nan=False, ensure_ascii=False).encode("utf-8")
        except (UnicodeError, ValueError, RecursionError) as exc:
            item["invalid_reason"] = f"Invalid Kafka JSON: {exc}"
        batch.append(item)
    return batch


def commit_batch(consumer):
    # 모든 유효 메시지의 delivery 완료 또는 명시적 invalid 폐기 후에만 호출한다.
    results = consumer.commit(asynchronous=False)
    failures = [result for result in (results or []) if result.error]
    if failures:
        raise RuntimeError(f"Kafka offset commit failed: {failures}")
auto commit을 false로 두었기 때문에, nlpworker에서 실제로 가공처리가 되어 성공적으로 produce가 된 메세지에 대해서 commit을 한다.
hdfs
원문을 저장해두기 위해, news.raw에 적재된 원문을 consume하여 저장한다.
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.serialization.StringDeserializer;

// Kafka Consumer 설정
        Properties kafkaProperties = new Properties();
        kafkaProperties.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);
        kafkaProperties.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
        kafkaProperties.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        kafkaProperties.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);
        kafkaProperties.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");
        kafkaProperties.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);
        kafkaProperties.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 500);

        try (
                // hdfs 연결
                FileSystem hdfs = FileSystem.get(URI.create(hdfsUri), hadoopConfiguration, hdfsUser);
                // consumer 생성
                KafkaConsumer<String, String> consumer = new KafkaConsumer<>(kafkaProperties)
        ) {
            // HDFS 출력 디렉터리 생성
            Path outputDirectory = new Path(outputPath);
            hdfs.mkdirs(outputDirectory);

            // 설정된 토픽 구독
            consumer.subscribe(List.of(topic));
            while (true) {
                // 데이터를 가져올 때 최대 5초까지 기다린다 (5초 동안 최대 MAX_POLL만큼의 레코드를 받을 수 있음)
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(5));
                if (records.isEmpty()) {
                    continue;
                }

                byte[] jsonLines = toJsonLines(records);
                // 파일명이 겹치지 않게 UUID로 설정
                String fileName = "batch-%d-%s.jsonl".formatted(
                        System.currentTimeMillis(),
                        UUID.randomUUID()
                );
                // 임시 파일과 최종 파일 구조 생성 (아직 실제로 만들어지진 않음)
                Path temporaryFile = new Path(outputDirectory, "." + fileName + ".tmp");
                Path finalFile = new Path(outputDirectory, fileName);

                // 임시 파일에 내용을 기록
                try (FSDataOutputStream output = hdfs.create(temporaryFile, false)) {
                    output.write(jsonLines);
                }
                // 완전히 내용이 다 임시 파일에 작성이 되면, 그때 최종 파일로 덮어쓰기 -> 최종 파일은 무조건 완전한 상태일 때만 나타남
                if (!hdfs.rename(temporaryFile, finalFile)) {
                    throw new IllegalStateException("Could not complete HDFS file " + finalFile);
                }
                // 성공적으로 최종 파일이 만들어지면 커밋 -> offset 갱신
                consumer.commitSync();
            }
        }
    }
이 consumer 역시, auto commit이 false이기 때문에, 실제로 완전히 hdfs에 저장이 되고 나면 커밋을 한다.
nlp worker에서 가공된 뉴스를 카프카에 적재
위에서 consume으로 원문을 읽어서 가공한 뉴스를 다시 news.enriched 토픽에 저장한다.
가공된 뉴스 메세지의 형태
{
  "nlp_worker_data": {
    "country_code": "KR",
    "language_code": "ko",
    "field_id": 1,
    "theme_id": 10,
    "theme_relevance_score": 0.88,
    "mentioned_countries": [
      {"country_code": "US", "count": 2}
    ],
    "sentiment": {"score": 50.0},
    "article_embedding": [0.1, 0.2, 0.3],
    "processed_at": "2026-09-13T00:06:00+00:00",
    "version": "v1"
  }
}
Producer 코드
from confluent_kafka import Producer
    def create_producer():
        return DeliveryProducer(Producer({
            "bootstrap.servers": KAFKA_BOOTSTRAP_SERVERS,
            "client.id": "nlp-worker",
            "acks": "all",
            "enable.idempotence": True,
            "compression.type": "snappy",
        }))

    def send_enriched_article(producer, article):
    payload = json.dumps(
        article, ensure_ascii=False, separators=(",", ":"), allow_nan=False,
    )
    producer.pending += 1
    try:
        producer.client.produce(
            topic=KAFKA_ENRICHED_TOPIC,
            key=article["article_id"],
            value=payload,
            on_delivery=producer.on_delivery,
        )
    except Exception:
        producer.pending -= 1
        raise
    producer.client.poll(0)
    if producer.errors:
        raise RuntimeError(f"Kafka delivery failed: {producer.errors}")
아까 말했듯이, produce를 하고 나서 commit을 한다.
def handle_batch(consumer, producer, batch):
    if not batch:
        return
    # archive 실패는 기존 동작대로 종료. 부분 append/재처리 중복은 가능하다.
    archive_batch(batch)
    articles = process_batch(batch)
    for article in articles:
        send_enriched_article(producer, article)
    flush_producer(producer)
    commit_batch(consumer)
    logger.info("Batch committed: consumed=%d enriched=%d invalid=%d",
                len(batch), len(articles), len(batch) - len(articles))
가공된 뉴스 데이터의 consume
가공된 뉴스 데이터가 쌓이는 news.enriched에 적재된 이벤트는 두가지 경로에 의해 소비가 된다.
- spark
- hdfs
spark
앞서 설명했던 comsumer들은 poll 메서드를 통해서, 주기적으로 "지금 소비할 메세지 있니?" 하고 물어보는 구조였다면,
spark에서는 Spark Structured Streaming이 카프카 메세지를 계속 읽고 일정 구간씩 Micro Batch로 묶어서 처리한다.
poll vs Spark Structred Streaming
굳이 poll 방식이 아닌 Spark Structed Streaming을 쓰는 이유는 다음과 같다.
| 구분 | poll() | Spark Structed Streaming |
|---|---|---|
| 메시지 소비 | 직접 구현 | Kafka Source로 처리 |
| 오프셋 관리 | 직접 commit 설계 | 체크포인트에 진행 위치 저장 |
| 10분 단위 집계 | 버퍼·타이머 직접 구현 | Window 연산 제공 |
| 최근 1시간 평균 | 이전 데이터를 직접 저장 | 상태 기반 집계 제공 |
| 늦게 도착한 기사 | 처리 기준 직접 설계 | Event Time·Watermark 제공 |
| 장애 복구 | 저장 위치와 중간 상태 복원 구현 | 체크포인트 기반 복원 |
| 병렬 처리 | 파티션·스레드 직접 관리 | 클러스터에 분산 실행 |
| SQL/DataFrame 연산 | 직접 작성 | SQL·DataFrame API 사용 |
우리 서비스에서는 기존 이슈의 유사도 매칭을 파티션 단위로 병렬처리하고, 배치 실행과 체크포인트 기반 복구를 일관된 체계로 관리를 해야할 필요성이 있었기 때문에, 이를 관리하기 용이한 Spark Structed Streaming을 사용했다.
enriched_stream = (
    spark.readStream.format("kafka")
    .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
    .option("subscribe", KAFKA_ENRICHED_TOPIC)
    .option("startingOffsets", SPARK_STARTING_OFFSETS)
    .option("failOnDataLoss", "true")
    .load()
)

query = (
    enriched_stream.writeStream.foreachBatch(write_event_batch)
    .option("checkpointLocation", SPARK_CHECKPOINT_LOCATION)
    .queryName("news-enriched-article-events-v1")
    .start()
)

def write_event_batch(batch_df, batch_id: int) -> None:

    spark = batch_df.sparkSession

    # Kafka Source의 value는 binary이므로 문자열로 변환한 뒤, 각 Partition에서
    # Enriched Article을 ARTICLE_UPSERT key/value 쌍으로 변환한다.
    article_rows = batch_df.selectExpr(
        "topic",
        "partition",
        "offset",
        "CAST(value AS STRING) AS value",
    ).rdd.mapPartitions(_transform_kafka_partition)
    article_df = spark.createDataFrame(article_rows, schema=ARTICLE_SCHEMA).cache()

    issues_by_theme = None
    try:
        # topic 옵션을 지정했기 때문에 각 Row에는 key와 value만 있으면 된다.
        (
            article_df.select("key", "value").write.format("kafka")
            .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
            .option("topic", KAFKA_EVENT_TOPIC)
            .save()
        )

        # 현재 배치에 포함된 Theme만 조회하여 불필요한 Issue 전체 스캔을 피한다.
        theme_ids = [
            row.theme_id
            for row in article_df.select("theme_id").distinct().collect()
        ]
        issues_by_theme = spark.sparkContext.broadcast(
            _load_issue_candidates(spark, theme_ids)
        )
        match_rows = article_df.rdd.mapPartitions(
            lambda rows: _match_partition(
                rows,
                issues_by_theme,
                ISSUE_MATCH_THRESHOLD,
                KAFKA_EVENT_TOPIC,
                KAFKA_UNCLASSIFIED_TOPIC,
            )
        )
        match_output_df = spark.createDataFrame(match_rows, schema=MATCH_OUTPUT_SCHEMA)

        # topic 컬럼 값에 따라 성공은 news.event.v1, 실패는
        # news.unclassified.v1으로 Kafka Sink가 분기한다.
        (
            match_output_df.write.format("kafka")
            .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
            .save()
        )
    finally:
        if issues_by_theme is not None:
            issues_by_theme.destroy()
        article_df.unpersist()
1차적으로 기사 row를 option에서 설정한 news.event 토픽에 발행한다.
Spark Structred Streaming
1차적으로 기사 row를 option에서 설정한 news.event 토픽에 발행한다.
    try:
        # topic 옵션을 지정했기 때문에 각 Row에는 key와 value만 있으면 된다.
        (
            article_df.select("key", "value").write.format("kafka")
            .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
            .option("topic", KAFKA_EVENT_TOPIC)
            .save()
        )
그 후에, 이 기사를 기존 이슈에 붙일 수 있는지 없는 지를 확인한다.
이 과정에서, 백엔드의 데이터베이스에 직접 조회 쿼리를 날려서, 기존 이슈와 매칭을 할 수 있는지 없는지 판단을 한 다음에, 그럴 수 있는 경우는 이슈 할당 이벤트를 news.event 토픽에, 그럴 수 없는 경우 news.unclassified 토픽에 저장을 한다.
if match is not None:
        event = {
            "event_type": ARTICLE_ISSUE_ASSIGNED,
            "occurred_at": article["occurred_at"],
            "payload": {
                "article_id": article["article_id"],
                "issue_id": match.issue_id,
                "similarity": match.similarity,
            },
        }
        return (
            event_topic,
            article["article_id"],
            json.dumps(event, ensure_ascii=False, separators=(",", ":")),
        )

    # 매칭되지 않은 기사는 다음 클러스터링 단계가 사용할 최소 정보만 보낸다.
    unclassified = {
        "article_id": article["article_id"],
        "theme_id": article["theme_id"],
        "embedding": list(article["embedding"]),
        "title": article["title"],
        "published_at": article["published_at"],
        "unclassified_at": article["occurred_at"],
    }
    return (
        unclassified_topic,
        str(article["theme_id"]),
        json.dumps(unclassified, ensure_ascii=False, separators=(",", ":")),
    )
기존 이슈에 할당되지 않은 뉴스들의 처리
이것 역시, spark structed streaming을 이용해서, news.unclassified 토픽을 읽는다.
stream = (
    spark.readStream.format("kafka")
    .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
    .option("subscribe", KAFKA_UNCLASSIFIED_TOPIC)
    .option("startingOffsets", SPARK_STARTING_OFFSETS)
    .option("failOnDataLoss", "true")
    .load()
)
query = (
    stream.writeStream.foreachBatch(write_cluster_batch)
    .option("checkpointLocation", SPARK_CHECKPOINT_LOCATION)
    .queryName("news-unclassified-issue-stream-v1")
    .start()
)
새롭게 클러스터링된 뉴스들은 별도의 py 파일에서 메세지를 발행한다.
def build_issue_events(
    cluster: ClusterCandidate,
    generated: GeneratedIssue,
    occurred_at: str | None = None,
) -> tuple[tuple[str, str], ...]:
    """Build the existing ISSUE_CREATE Kafka key/value contract."""

    occurred_at = occurred_at or datetime.now(timezone.utc).isoformat()
    first_seen_at = min(
        cluster.articles,
        key=lambda article: datetime.fromisoformat(
            article.published_at.replace("Z", "+00:00")
        ),
    ).published_at
    event = {
        "event_type": ISSUE_CREATE,
        "occurred_at": occurred_at,
        "payload": {
            "theme_id": cluster.theme_id,
            "name": generated.name,
            "embedding": list(cluster.centroid),
            "article_ids": sorted(article.article_id for article in cluster.articles),
            "first_seen_at": first_seen_at,
        },
    }
    return (
        (
            cluster_event_key(cluster),
            json.dumps(event, ensure_ascii=False, separators=(",", ":")),
        ),
    )


for cluster, generated in merge_generated_issue_candidates(
    generated_candidates
):
    event_rows.extend(build_issue_events(cluster, generated))

if event_rows:
    event_df = spark.createDataFrame(event_rows, schema=EVENT_SCHEMA)
    (
        event_df.write.format("kafka")
        .option("kafka.bootstrap.servers", KAFKA_BOOTSTRAP_SERVERS)
        .option("topic", KAFKA_EVENT_TOPIC)
        .save()
    )
DB Writer
최종으로, news.event에 저장된 메세지들은 제일 끝단인 DB Writer에서 consume되어 DB에 저장된다.
comsume 환경 설정
kafka:
  bootstrap-servers: 172.26.11.46:19092
  consumer:
    group-id: db-writer-v1
    auto-offset-reset: latest
    enable-auto-commit: false
    key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
    value-deserializer: org.apache.kafka.common.serialization.StringDeserializer
  listener:
    ack-mode: record
consumer 코드
@KafkaListener(topics = "news.event.v1", groupId = "db-writer-v1")
    public void consume(ConsumerRecord<String, String> record) {
        DbWriterEvent event = deserialize(record.value());
        dbWriterService.handle(event);
    }

    private DbWriterEvent deserialize(String value) {
        try {
            return objectMapper.readValue(value, DbWriterEvent.class);
        } catch (JacksonException exception) {
            throw new IllegalArgumentException("Invalid news.event.v1 message", exception);
        }
    }


@Transactional
    public void handle(DbWriterEvent event) {
        require(event, "event");
        requireText(event.eventType(), "event_type");
        require(event.occurredAt(), "occurred_at");
        require(event.payload(), "payload");

        switch (event.eventType()) {
            case ARTICLE_UPSERT -> upsertArticle(convert(event, ArticleUpsertPayload.class));
            case ARTICLE_ISSUE_ASSIGNED -> assignArticleToIssue(
                    convert(event, ArticleIssueAssignedPayload.class), event.occurredAt()
            );
            case ISSUE_CREATE -> createIssue(
                    convert(event, IssueCreatePayload.class), event.occurredAt()
            );
            default -> throw new IllegalArgumentException(
                    "Unsupported DB Writer event_type: " + event.eventType()
            );
        }
    }